 By Mark
Google Trend (구글 트렌드)는 구글에서 제공하는 데이터 분석 도구로, 특정 키워드의 검색량 변화를 시간에 따라 시각적으로 보여줍니다. 사용자는 특정 기간, 지역, 언어 등을 설정하여 검색 트렌드를 분석할 수 있습니다.
주요 기능
- 검색량 변화 분석: 특정 키워드가 언제, 얼마나 검색되었는지 확인 가능.
- 지역별 관심도 분석: 국가 및 도시별 검색량 비교 가능.
- 관련 키워드 및 주제 추천: 유사한 키워드와 상승세인 검색어 제공.
- 비교 기능: 최대 5개의 키워드를 비교하여 트렌드 분석 가능.
- 실시간 검색 트렌드: 현재 급상승 검색어 확인 가능.
활용 사례
- 마케팅 및 SEO: 인기 검색어를 분석하여 콘텐츠 및 광고 전략 수립.
- 시장 조사: 특정 상품이나 서비스의 인기도와 관심 변화를 파악.
Google Trend : https://trends.google.co.kr/trending?geo=KR&hl=ko
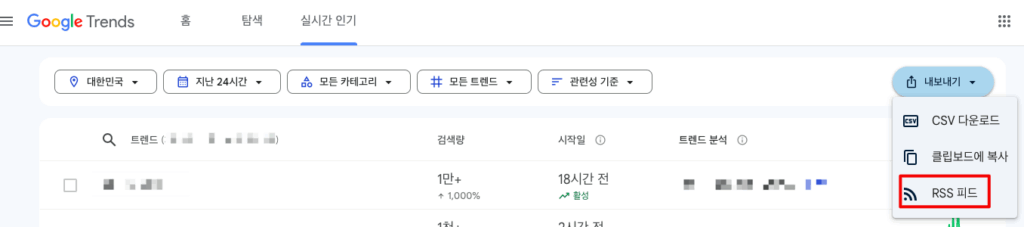
RSS Feed
Python pip
pip install feedparser트렌드 데이터 가져오기
# pip install feedparser

import datetime
import sys
import os
import feedparser

sys.path.append(os.path.dirname(os.path.abspath(os.path.dirname(__file__))))
# SSL 인증서 검증은 끄지 않고 기본값(활성)을 그대로 사용합니다.


def get_trend(national):
    feed = feedparser.parse('https://trends.google.co.kr/trending/rss?geo=' + national)
    indexs = ['title', 'ht_approx_traffic', 'ht_news_item_title', 'published']
    head_message = f'[Google Trend - {national}]\n'

    today = datetime.date.today()
    yesterday = datetime.date.today() - datetime.timedelta(days=1)
    today_day_of_week = today.strftime("%a")
    today_day = today.strftime("%d")
    yesterday_day_of_week = yesterday.strftime("%a")
    yesterday_day = yesterday.strftime("%d")
    message = ''

    for item in feed.entries:
        try:
            for index in indexs:
                print(f'{index}: {getattr(item, index)}')
        except:
            continue
        tmp = str(item.published).replace(",", "")
        tmp_time = tmp.split(" ")

        if (len(item.ht_approx_traffic) > 6) and ((today_day_of_week == tmp_time[0] and today_day == tmp_time[1]) or (
                yesterday_day_of_week == tmp_time[0] and yesterday_day == tmp_time[1])):
            message += f"  {item.title} ({item.ht_approx_traffic}) - {str(item.ht_news_item_title).replace(''', '').replace('"', '')}\n"
        else:
            continue
    return str(head_message + message)


if __name__ == "__main__":
    #print("Google Trend plugin Create!")
    nationals = ['KR', 'US', 'GB', 'JP', 'HK', 'IN', 'TW']

    for national in nationals:
        print(f"Google Trend {national} data get")
        print(get_trend(national))
코드 설명
이 스크립트는 국가 코드(KR, US, GB, JP, HK, IN, TW)마다 Google Trends의 급상승 검색어 RSS를 읽어서, 어제와 오늘 발행된 항목 중 검색량이 큰 것만 한 덩어리 문자열로 만들어 돌려줍니다.
- RSS 읽기:
feedparser.parse()에?geo=국가코드를 붙인 주소를 넘깁니다. 코드에서는 모든 국가에trends.google.co.kr도메인을 그대로 씁니다. - 필드 출력: 항목마다
title,ht_approx_traffic(대략적인 검색량),ht_news_item_title(관련 뉴스 제목),published를 출력합니다. 아래 “Output” 예시는 이 출력이라 필터를 거치기 전의 결과입니다(그래서 검색량 100+ 항목도 보입니다). - 날짜 비교:
published문자열에서 요일과 일(day)을 잘라내 오늘·어제와 비교합니다. 월이나 연도는 비교하지 않습니다. - 검색량 필터:
ht_approx_traffic문자열 길이가 6자를 넘는 항목(예:100000+)만 최종 메시지에 담습니다. 숫자를 파싱하지 않고 자릿수로 거르는 단순한 방식입니다.
SSL 검증에 대해: 원래 코드에는 인증서 검증을 끄는 ssl._create_unverified_context 설정이 있었는데, 통신 내용을 중간에서 가로챌 수 있게 되므로 제거했습니다. 회사망이나 프록시 때문에 인증서 오류가 난다면 검증을 끄는 대신 해당 환경의 CA 인증서를 지정하는 쪽을 권합니다.
Output Main Code
Google Trend KR data get
title: lg ai
ht_approx_traffic: 100+
ht_news_item_title: LG to take on OpenAI, DeepSeek with Korea first reasoning AI model
published: . . . . . . . . .
. . .

title: 勝利
ht_approx_traffic: 100+
ht_news_item_title: 選抜高校野球、柳ヶ浦・杉本は初のエースナンバーで手応え…二松学舎大付に敗れるも「通用するとわかった」
published: . . . . . . . . .
구글 트렌드는 기본적으로 사용자들의 검색 데이터를 수집하고 분석하는 것에 초점을 맞추고 있지만, 이러한 데이터는 단순한 검색량 분석을 넘어 다양한 분야에서 활용될 가능성이 큽니다.
예를 들어, 기업들은 Google Trend 데이터를 활용하여 소비자들의 관심 변화를 파악하고, 이를 바탕으로 마케팅 전략을 수립하거나 신제품 출시 시기를 조정할 수 있습니다. 또한, 언론사나 연구 기관에서는 특정 키워드의 검색 패턴을 분석하여 사회적 트렌드, 경제 변화, 정치적 이슈 등의 흐름을 예측하는 데 활용할 수도 있습니다.
이러한 점에서 Google Trend 는 단순한 검색 데이터 분석 도구를 넘어 미래 예측 및 전략 수립을 위한 중요한 정보 자원으로 활용될 수 있을 것이라 생각합니다. 이후 문장분석이나 요약하는 방법도 블로그에 작성해보겠습니다.